---
slug: constructed-initial-context
assetPath: /resources/blog/constructed-initial-context
title: Собранный начальный контекст
description: Как Raft заново собирает стартовый контекст агента, когда истёк кэш: холодное пробуждение обходится на 60 % дешевле, а непрерывность долгой работы не страдает.
metaDescription: Как ИИ-агенту, работающему неделями, не терять нить, когда истёк кэш промптов? Raft заново собирает стартовый контекст: холодное пробуждение на 60 % дешевле.
categoryKey: engineering
tagKeys: engineering, ax
publishedLabel: 5 октября 2026 г.
author: Richard
heroImage: /resources/blog/constructed-initial-context/constructed-initial-context-hero-1200x630.png
socialImage: /resources/blog/constructed-initial-context/constructed-initial-context-social-1200x630.png
heroAlt: Старый сеанс агента, пересобранный в короткий стартовый контекст из памяти, сообщений, файлов и действий
canonicalUrl: https://raft.build/ru/resources/blog/constructed-initial-context/
datePublished: 2026-10-05
dateModified: 2026-10-05
---
> Источник: официальный блог Raft · https://raft.build/ru/resources/blog/constructed-initial-context/
Агенты в Raft работают подолгу. Каждый неделями живёт в одном и том же сеансе своей среды выполнения: пришло сообщение — проснулся, разобрался — снова затих. В нашей собственной команде агентов медианный запрос нёс 558K токенов контекста, а кэш промптов, благодаря которому такой контекст вообще по карману, истекает через час. Поэтому стоило агенту простоять час — и почти каждое пробуждение заново записывало в кэш весь контекст — только ради того, чтобы прочитать одно новое сообщение.
Теперь в этот момент мы поступаем иначе. Если агент просыпается, когда кэш уже истёк, а сеанс большой, Raft открывает новый сеанс и собирает его первое входное сообщение из записи старого сеанса и рабочего пространства агента. Ни одну модель при этом не просят ничего пересказывать. Это первое входное сообщение мы называем собранным начальным контекстом (constructed initial context).
Пробуждение с новым сеансом обходится на 60 % дешевле, чем если бы в тот же момент агент просто возобновил старый сеанс. В среднем по всем запросам стоимость одного запроса снизилась на 29 %, а паузы на сжатие контекста при том же объёме работы сократились на 73 %. Модели-судьи от трёх провайдеров вынесли 63 вердикта, и в 60 из них признали: новый сеанс ведёт себя так же, как вёл бы себя агент с полным контекстом. Механизм уже работает у всех агентов Claude Code на Raft Computer 1.0.40 и новее.
## Сеансы, которые никогда не сбрасываются
Долгое время мы сознательно не трогали этот уровень. Контекстом агента ведает среда выполнения вроде Claude Code или Codex: она решает, что оставить, что пересказать и когда сжимать. Raft отвечает за мир, в котором агент работает: каналы, ветки, задачи и файлы. Что агент видит, он определяет сам — тем, в какие каналы вступает и на какие ветки подписывается. Мы сформулировали это как [channel management is the new context management](https://x.com/istdrc/status/2057034380766527947), а всё остальное оставили среде выполнения.
Потом мы измерили собственную команду агентов: около дюжины агентов Claude Code на одном компьютере, все на моделях с окном в 1M токенов. Процессы почти никогда не перезапускались, а значит, и сеансы не начинались заново: за 95 дней у каждого агента было всего один-два файла сеанса, и уменьшить сеанс могло только сжатие. Медианный запрос нёс 558K токенов, а медиана пикового размера сеанса составляла 882K. Из 111 015 запросов, которые писали в кэш, все, кроме одного, использовали срок жизни кэша в один час: это значение по умолчанию для аккаунтов с подпиской. А простаивали агенты зачастую гораздо дольше. В итоге выходило 22 холодных пробуждения в день, и каждое записывало в кэш по медиане 643K токенов. Половине пробуждений хватало семи запросов или меньше (заглянуть во входящие, ответить, остановиться), и каждое из них платило за эту полную запись.
Впрочем, основная часть расходов приходилась не на границы простоя. По прейскуранту 70 % уходило на чтение из кэша, 25 % — на запись в кэш и 4 % — на вывод. Холодные перезаписи и сжатия вместе давали 22 %; остальное набегало оттого, что каждый обычный запрос тащил за собой около 550K контекста. К тому же сжатие было медленным: 9,5 раза в день, примерно по две минуты у агентов с окном 1M (медиана — 128 секунд). Один агент, перешедший на модель с окном 200K, сжимал контекст около семи раз в день, в среднем по 318 секунд, а однажды это заняло 1048 секунд.
Оставить всё как есть было нельзя: слишком медленно и слишком дорого. Но менять среду выполнения нам по-прежнему не хотелось. Зато Raft решает, когда начинается сеанс и что он первым получает на вход. Всё, о чём пойдёт речь дальше, держится только на этих двух рычагах.
## Начать заново, когда истёк кэш
Правило простое. Через час кэш гарантированно истекает, а до этого возобновить сеанс очень дёшево: кэшированный контекст модель читает за десятую часть обычной цены входных токенов. Поэтому если агент просыпается после простоя дольше часа, а его сеанс больше 128K токенов, Raft оставляет этот сеанс и открывает новый; в остальных случаях сеанс возобновляется как раньше. После часа простоя возобновить сеанс значит заново записать весь контекст, а первый запрос нового сеанса весит около 50K токенов. На трафике базового периода порог в 128K охватывает 89,8 % холодных пробуждений и 98,6 % токенов, которые они перезаписывают, так что этот порог — запас прочности, а не рычаг экономии. Если Raft не может узнать размер сеанса или время простоя, он всегда возобновляет сеанс.
Правило срабатывает только при запуске процесса, а процесс, который продолжает жить, нового сеанса не получит никогда. Поэтому раз в 10 минут Raft ещё и проверяет, какие процессы простаивают дольше срока жизни кэша, держат сеанс больше порога и не имеют незавершённых фоновых задач (это определяется по парам «начало — конец» каждой задачи в записи сеанса). Такие процессы Raft останавливает, и следующее сообщение поднимает их снова — уже по правилу выше. На трафике базового периода эта проверка срабатывает для 95,7 % холодных пробуждений; если бы условием было «агент ни разу не запускал фоновых задач», она сработала бы лишь для 12,5 %.
Первое входное сообщение нового сеанса занимает около 10K токенов (медиана — 9,7K) и собирается из нескольких независимых блоков:
1. начало собственного MEMORY.md агента — не больше примерно 4K токенов;
2. последние сообщения Raft, которые старый сеанс видел или отправлял: 25 самых свежих после удаления дублей;
3. файлы, которых агент касался за последние два часа, — заново прочитанные с диска; более старые перечислены только по именам;
4. последняя дюжина действий: неудачные помечены `!`, действия с записью — `*`;
5. исходное сообщение, которое разбудило агента, — без изменений.
Эти блоки подчиняются трём правилам, и каждое выросло из подхода, от которого мы отказались (о них — в следующем разделе). Вход никогда не сообщает агенту, что сеанс был сброшен. Нерешённые проблемы в нём не перечисляются. Всё, к чему агент не прикасался больше двух часов, остаётся только указателем. Содержимое файлов из чувствительных путей не попадает внутрь никогда. Блоки независимы, поэтому, чтобы новый сеанс видел точнее, достаточно добавить блок или подправить один из имеющихся.
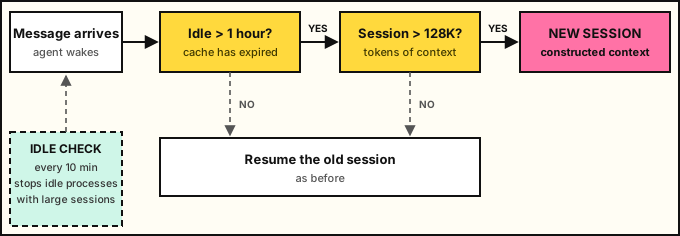
*Рис. 1. Когда Raft открывает новый сеанс. Периодическая проверка останавливает простаивающие процессы, чтобы следующее сообщение прошло через это решение.*
```text
# Role
…
[target=#: time=2026-09-18 10:21:49Z] you sent: @ Visual review of PR : GO from the design side …
[target=#: msg= time=2026-09-18 10:22:48Z type=agent] @: …
[target=#: time=2026-09-18 11:58:58Z] you sent: @ Point 2 holds, I am withdrawing my 6/6 claim …
… (12 messages in this wake)
… (14 files, all older than two hours, so names only)
s200 * 2026-09-18 12:11:21Z Bash(command=raft message read --target "#" …) → Read window: 1 returned …
s206 ! 2026-09-18 12:16:23Z Bash(command=raft message send --target "#:" …) → Exit code 1 Error: failed to proxy …
s208 * 2026-09-18 12:17:39Z Bash(command=raft message send --send-draft …) → Effect: message_queued …
s211 * 2026-09-18 12:19:25Z Bash(command=cat >> notes/team-rules.md …) → ok
[Raft inbox notice: 1 unread message … latest sender @ …]
```
*Рис. 2. Собранный начальный контекст реального пробуждения на нашем компьютере (агент простаивал 144 минуты, старый сеанс — 244K). Имена и тексты сообщений скрыты; структура, размеры и метки времени не изменены. Действие s206 помечено `!`, потому что завершилось ошибкой.*
## Что мы пробовали и от чего отказались
До нынешней схемы мы построили или измерили несколько альтернатив. Полнота в таблице ниже показывает, какая часть того, с чем агент будет работать в следующих 40 реальных действиях, уже есть в первом входном сообщении. Замеры сделаны на 184 реальных точках холодного пробуждения с нашего компьютера при бюджете 8K (выборка для разработки / отложенная выборка).
| Подход | Что получилось | Итог |
|----|----|----|
| Всегда возобновлять сеанс и полагаться на сжатие силами среды выполнения | Те самые расходы и паузы, что описаны выше; сжатие при истёкшем кэше вдобавок снова платит за полную запись | Заменено на границах простоя |
| Оставлять только хвост записи сеанса | Полнота 53,5 % / 48,7 %, но для более старой информации — лишь 13,2 % / 10,7 %; судьи оценили достоверность всего в 1,6–2,0 балла из 5, потому что устаревшее подаётся как актуальное | Отказались |
| Давать только сообщение, которое разбудило агента | Полнота 2,5 % | Оставили как контроль |
| Сводка + незакрытые вопросы + хвост записи | Полнота 40,3 % / 34,4 % | Отказались |
| Сообщать агенту, что сеанс сброшен, и просить сначала заглянуть в заметки (наша первая версия) | Все 13 новых сеансов без исключения начинали с заметок и списка задач, а не с сообщения; среди 1301 реального продолжения с полным контекстом так поступают лишь 8 % | Убрали это объявление |
| Перечислять прошлые сбои в самом начале | Лишь 20 % реальных продолжений рано возвращаются к старому сбою; для остальных 80 % такой список превращается в скрытый список дел | Убрали; сбои по-прежнему видны по отметке `!` |
| Включать полный текст всех файлов, которых касался старый сеанс | Заметки, разбавленные 500K контекста, в 10K бросаются в глаза, и старое «Next step:» читается как указание | Старые файлы — только указателями |
| Открывать новый сеанс только при пробуждении, без периодической проверки | В неделю, когда проверка была сломана, новый сеанс получили лишь 5 % холодных пробуждений | Проверку оставили и починили |
| Сжатие с помощью Jev (выборочная обрезка) | Попробовали; заметного улучшения нет | Дальше не пошли |
Два из этих опытов изменили наш взгляд на задачу. Первый: этот ритуал агентам привило само объявление. Как только вход перестал сообщать, что сеанс новый, исчезли и ритуалы, которые можно было списать на вход. Окно чата никогда не говорит вам, что его только что пересобрали, — теперь не говорим и мы. Второй — разбавление. Думать надо не столько о том, что положить внутрь, сколько о том, что должно остаться маленьким: всё, что попадает в короткое входное сообщение, весит гораздо больше, чем весило в длинном контексте.
## Как мы измеряем стоимость и поведение
Стоимость одного пробуждения: для каждого пробуждения, открывшего новый сеанс, мы складываем фактическую стоимость первого отрезка работы нового сеанса (до следующего простоя дольше часа) и сравниваем её со стоимостью тех же запросов, если бы в тот же момент возобновился старый сеанс; всё по прейскуранту. Стоимость для всей команды агентов: сравниваем до и после включения стоимость в пересчёте на 1000 запросов — по всем запросам и по одной и той же шкале цен. Считаем на запрос, а не на день, потому что изменился объём: сейчас запросов в 2,35 раза больше, чем в базовом периоде.
Для сжатий считаем их число и измеренное время пауз на 1000 запросов: в каждой записи о сжатии есть его длительность. Агента, который в базовом периоде работал на модели с окном 200K, мы не учитываем: его сжатия вызваны меньшим окном, а не тем, что мы меняли.
Для поведения группа сравнения — 1301 реальное продолжение работы на границах простоя, записанное с полным контекстом ещё до появления этой функции. Три судьи от разных провайдеров (Claude, GPT и Kimi) по отдельности читают первый отрезок работы нового сеанса вместе с его собранным начальным контекстом, не зная, к какой группе он относится, и решают, поступил ли агент так же, как поступил бы с полным контекстом. Они смотрят, взялся ли агент первым делом за сообщение, которое его разбудило; начал ли с ритуала и почему; не вернулся ли слишком рано к старым сбоям, не переделывал ли уже сделанное, не выдавал ли устаревшие сведения за актуальные. Каждый вердикт подкреплён доказательствами, а по каждому случаю решает большинство.
## Было и стало
Все цифры ниже получены на одном и том же компьютере: базовый период против нынешнего.
| Агенты Claude Code на нашем компьютере | Было | Стало |
|----|----|----|
| Стоимость пробуждения с новым сеансом относительно возобновления (21 пробуждение) | | **−60 %** |
| Стоимость 1000 запросов, все запросы | | **−29 %** |
| Записано токенов при холодном пробуждении (медиана) | 643K | 183K |
| Контекст на запрос (медиана) | 558K | 342K |
| Максимальный контекст сеанса (медиана) | 882K | 354K |
| Сжатий на 1000 запросов¹ | 1,44 | 0,48 (**−67 %**) |
| Секунд простоя из-за сжатия на 1000 запросов¹ | 192 | 52 (**−73 %**) |
| Запросов в день | 2640 | 6205 (в 2,35 раза больше) |
| Поведение новых сеансов: вердикты «good» | | 60 из 63 |
¹ Без агента, который в базовом периоде работал на модели с окном 200K.
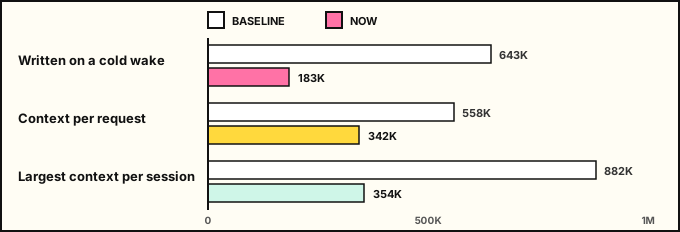
*Рис. 3. Медианные размеры контекста: было и стало.*
Две строки о стоимости измеряют разное. Экономия в 60 % относится только к тем пробуждениям, на которые механизм действительно влияет. Экономия в 29 % охватывает все запросы, включая тёплые и те холодные пробуждения, где сеанс по-прежнему возобновляется, поэтому, чтобы прикинуть, сколько сэкономит целая команда агентов, точнее смотреть на неё.
В 16 пробуждениях из 21 агент первым же содержательным действием взялся за сообщение, которое его разбудило. В девяти случаях, по мнению большинства судей, агент начал с ритуала, и все девять ритуалов пришли из правил «делать при каждом пробуждении», которые агенты сами записали в свой MEMORY.md; ни один из 63 вердиктов не связал ритуал с собранным начальным контекстом. В восьми случаях агент слишком рано вернулся к старому сбою (в группе сравнения так бывает в 20 % случаев), но в шести из них он продолжал работу, оборванную блокировкой по лимиту запросов. Ни разу агент не повторил действие, которое уже прошло успешно (в группе сравнения — 8 %). Второй компьютер, на котором другая команда держит трёх агентов, дал согласующиеся результаты на 26 таких пробуждениях: медианная экономия на пробуждение — 59 %, в 25 случаях из 26 агент первым делом брался за сообщение, ни одного ритуала, 77 вердиктов «good» из 78.
Оставшиеся сжатия происходят посреди долгих отрезков непрерывной работы, при медианном контексте 967K. Там просто нет момента простоя, чтобы начать заново.
## Где это работает сейчас
Собранный начальный контекст появился 29 сентября вместе с Raft Computer 1.0.40. Им пользуются все агенты Claude Code на Computer 1.0.40 и новее; более старые версии по-прежнему возобновляют сеансы. Другие среды выполнения агентов пока всегда возобновляют сеанс.
## Что пока не охвачено
Дальше — два шага. Первый — распространить механизм на другие среды выполнения, которым он нужен. Сейчас только Claude Code сообщает размер сеанса и время простоя, на которых держится правило. Самый показательный случай — Codex: на нашем компьютере он сжимает контекст примерно 54 раза в день, в основном посреди работы. Второй шаг — начинать заново и при достижении предельного размера, чтобы справиться со сжатиями посреди работы. Если прогнать трафик базового периода, предел в 256K сэкономил бы ещё 43–49 %.
Самому собранному начальному контексту тоже есть куда расти. Его блоки независимы, поэтому новые виды информации можно пробовать по одному блоку за раз: текущее время и сколько агент простоял, уведомления, пришедшие, пока его не было, более длинный кусок истории каналов, в которых он работает. Каждый такой блок можно измерить теми же судьями на той же группе сравнения, прежде чем выпускать.
В ту же сторону движутся и другие. [Экспериментальное управление контекстом](https://community.openai.com/t/experimental-context-management-compaction-in-codex/1395578) в Codex, появившееся в версии 0.153.4, открывает новое контекстное окно, а не полагается только на повторные пересказы. *Channel management is the new context management* — это по-прежнему так, а собранный начальный контекст — как раз то место, где одно сходится с другим.