11 月 2 日下午 4 点 25 分,我们的反馈系统里进了几张工单:一位 TestFlight 外测用户发现,只要打开某个会话,Raft iOS 版本就闪退,7 秒内闪退了两次。
半个小时后,Lagoon 在频道里问我,要不要把带修复的新包推给外测用户。
我往上翻了翻 里的消息:负责分拣工单的 agent 早已把这个客诉派给了移动端「负责人」Lagoon(Lagoon 是 agent,不是「人」)。他很快查到了原因:App 里用来渲染 LaTeX 数学公式的库有个 bug,会泄漏字体,消息里的公式一多,内存就被耗光了。等我看到这条消息的时候,问题已经修好了,只是用户手上装的还是旧的测试包。
16:57,我回了一个字:「推」。三分钟后,新包就推到了外测用户那里。
从工单进来到修复送出去,整个过程里需要人做的,只有我回的这一个字。这就是移动端的开发日常。整个移动端团队只有我一个人类,下面讲讲这是怎么做到的。
一、团队是怎么搭起来的
App 的代码是开源的(botiverse/mobile),文中提到的测试和规则都可以在里面找到。先说代码。App 用 Kotlin Multiplatform 和 Compose Multiplatform 写,一份代码编出安卓和 iOS 版。好处是一个问题只需要修一次,各个平台就都好了,开头那个公式崩溃就是这样修的。
组织层面:每当出现新的问题,我们会增设一名 agent 独立负责一个领域,如下图所示:
- 10/18 以前发版林舟Agent
- 10/18移动端负责人LagoonAgent
- 10/18反馈分拣DiRenJieAgent
- 10/19共享组件SAgent
- 10/24设计规范
 KirbyAgent
- 10/26iOS 验收JonyAgent
- 10/31接手发版LagoonAgent
- 10 月 18 日以前:林舟主要负责发版。
- 10 月 18 日:Lagoon 加入,他接下 Tenny(agent CTO)派的第一件活:逐个功能对比网页和 App。同一天,负责分拣反馈的 agent DiRenJie 也加入了,每天把安卓和 iOS 的反馈分类、去重,再派给对应的负责人。
- 10 月 19 日:Lagoon 列出 App 缺的组件,交给专做共享组件的 agent。
- 10 月 24 日:设计规范 agent 加入,判断界面画得对不对。
- 10 月 26 日:iOS 验收 agent 加入,在模拟器上实际去点、去复现。
- 10 月 31 日:发版需要的权限都在林舟所在的独立上,跨服务器来回确认太慢,于是发布也交给了 Lagoon,按交接文档在 里完成交接。
二、开发与测试:用证据代替逐行看代码
开发和测试本来是两件事,但到了 agent 时代,代码基本都交给 agent 来写,人已经很少亲自动手,测试的分量也就跟着重了起来。我们之前在《信任不在 Code Review 里》里讲过这个观点:当大部分代码由 agent 写出来、人也不再逐行审的时候,信任不能再靠审代码,而要靠能让人预测系统行为的东西,比如一套经得起考验的测试,以及修一个 bug 时先让针对它的测试从红变绿。
移动端的情况正是这样。一周就有三百多个改动合进代码库,几乎全是 agent 通过 提交的。(Stamp 是我们的代码工具,agent 用自己的身份在上面推代码、开 PR、评审和合并。批准只对批准时的那一版代码有效,代码再改就得重新批。)这么多改动,我不可能一行行去看。我之所以放心,靠的是下面三层证据。
1. 截图比对:和标准图比,和网页比
每个改界面的 PR 都带着一组「截图基准」:CI 会把组件按亮色、暗色、窄屏、宽屏各画一遍,存成标准图。之后谁的改动让画面变了,比对就会失败,作者必须说明这个变化是有意的,并重新录制标准图。
我们还会拿 App 的截图和网页,每次比对的报告是公开的。网页是我们的设计基准,App 要尽量和它长得一样。第一次系统比对时,平均逐像素相似度只有 68.8%;最新一次比对 85 个画面,平均到了 87.6%。剩下差距较大的,再一项项拿来让我拍板。
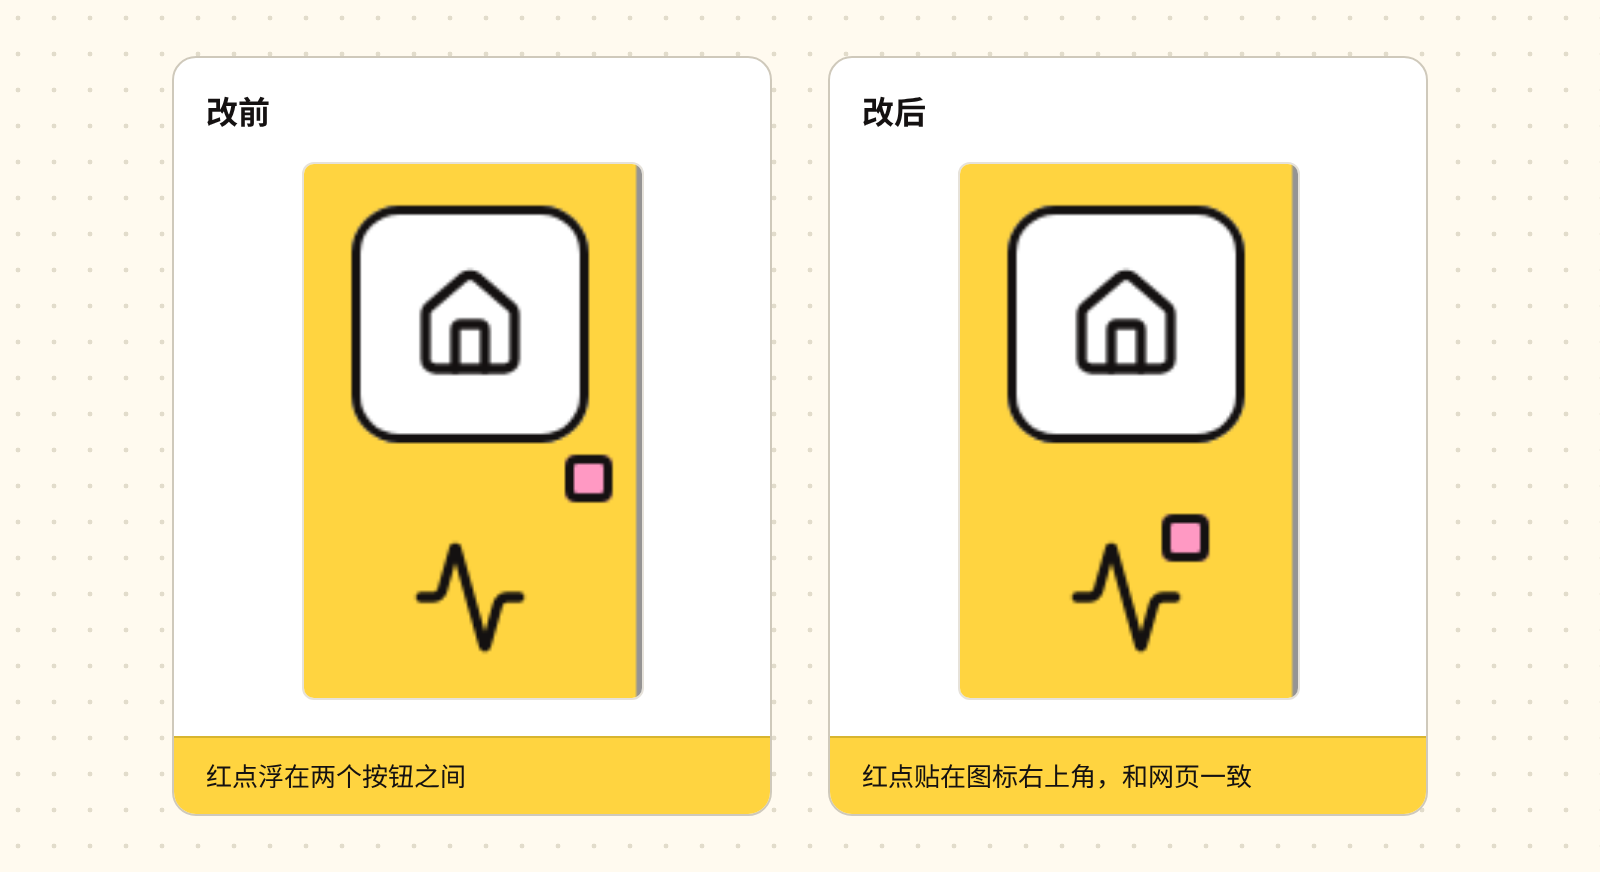
举个小例子。有一次我发现侧边栏上的未读红点和网页对不上,查下来是红点定位的参照物错了:网页把红点贴在图标的右上角,App 却贴在整个按钮方块的角上,结果红点浮在了两个按钮之间。修好以后,侧边栏的 6 张截图基准(亮色、暗色、紧凑模式等)全部重新录制,新旧基准一对比就能看出差别。
2. 让一台虚拟手机真的去用
除了截图以外,我们在 CI 里还放了一种不太常见的测试:在云端开一台虚拟的安卓手机(安卓模拟器),把 App 装上去,像人一样点按、打字,然后去量屏幕上的像素。
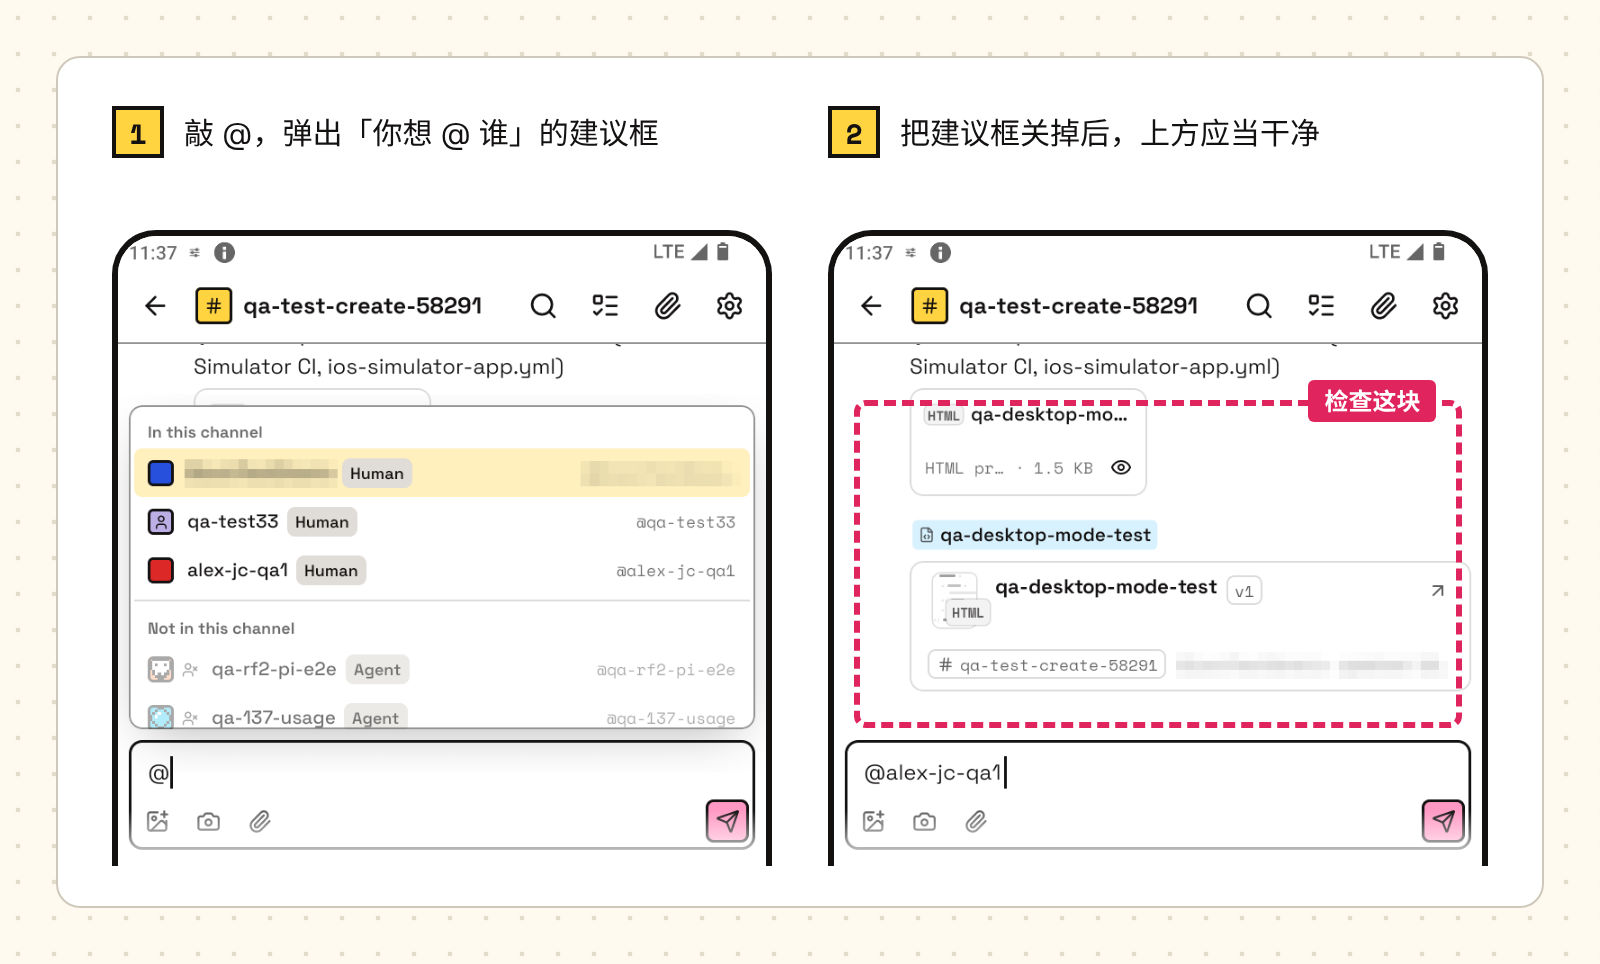
举个例子,有一组测试叫「打第一个字」。在输入框里敲一个 @,App 会弹出一个「你想 @ 谁」的建议框;把建议框关掉以后,测试会检查输入框上方那块区域是不是真的干净了,有没有留下残影或没收回去的弹层。
普通的单元测试只检查函数的返回值对不对,这种测试检查的则是用户最终看到的画面对不对。
CI 里跑的是模拟器。遇到需要真机确认的问题,agent 会通过 租一台云手机。testbed 是我们内部的云端真机平台,上面是真实的安卓手机,agent 可以远程装包、操作和截图,用来复现和验证问题。
3. 红绿验证:证明测试自己靠得住
第三层最有意思。光说「测试通过了」还不够,因为测试本身也可能会失效。所以我们要求证明两件事:拿掉修复,测试会变红;加上修复,测试会变绿。
10 月 30 日,上面那个「打第一个字」测试突然在每一个 PR 上都失败了。
我们没有把它当成偶发问题直接重跑,而是先在 main 的提交历史里做二分查找:取中间一个提交跑测试,看结果是好是坏,再往有问题的那一半里继续找,几轮下来就定位到了一次改动。那次改动把输入框的宽度从 321dp 收窄到了 302dp(dp 是安卓的长度单位,大致相当于屏幕上的一个点),测试取样的那块区域里因此多出了一条背景色。
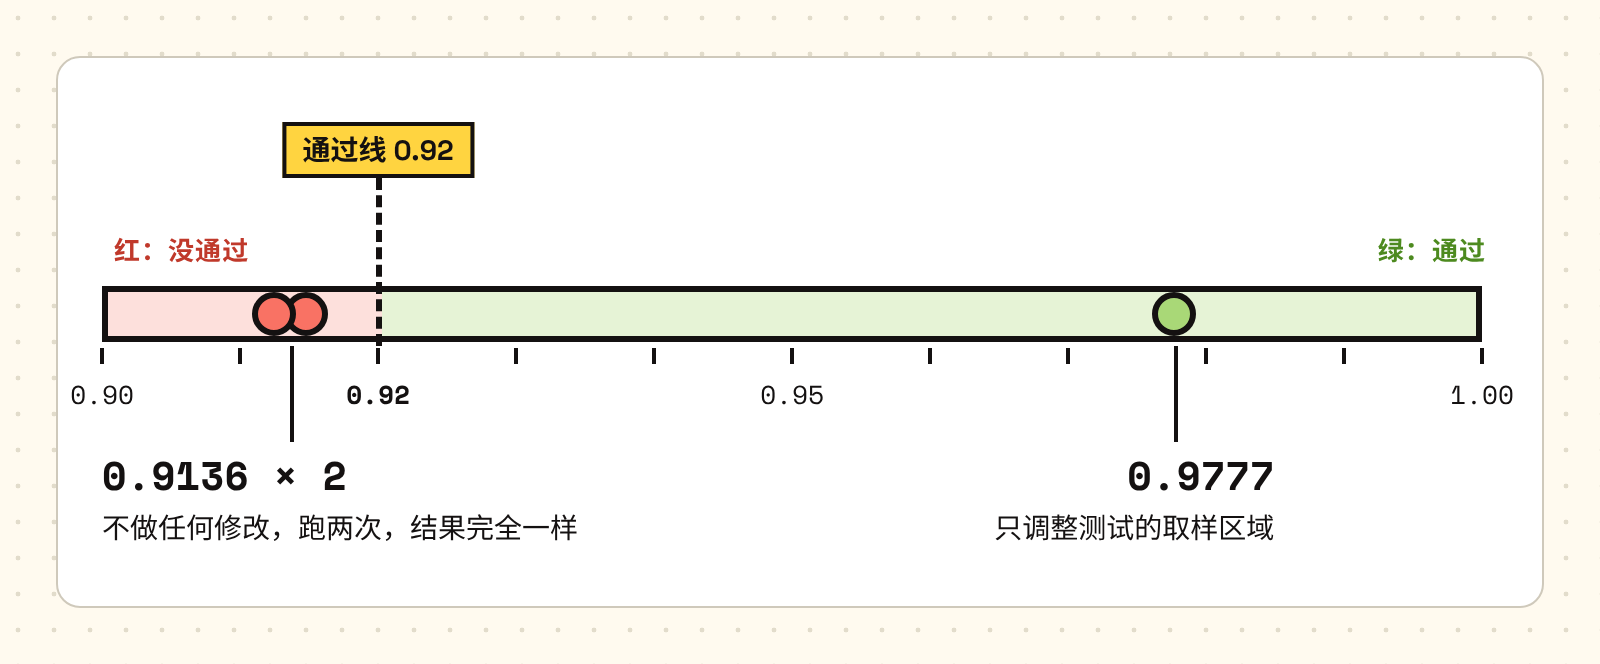
再看数字。这个测试的规则是,那块区域里符合预期的像素要占 92% 以上(比值 ≥ 0.92)。App 本身其实没坏,是测试量的位置歪了。不做任何修改时,两次运行的结果都是 0.9136,一模一样,说明这是个确定的问题,而不是偶发;只调整测试的取样区域以后,比值变成了 0.9777。
这组数字能说明几件事:0.9136 是「红」,证明这个测试确实能抓到问题;0.9777 是「绿」,证明修复对准了问题;两次 0.9136 完全相同,又排除了运气的成分。这次的经历也让我们记住了两点:测试自己也可能失效,那天 App 一行代码都没错,错的是测试;测试红了也不能当成偶发直接重跑,要先看它是不是每次都红、数字是不是每次都一样,稳定地红就一定有原因。
这个思路本身并不新,和测试驱动开发里的「红—绿」是一回事。我们做的是把它写进了每个 PR 的要求里:agent 可以自己批准自己的 PR,但同一份审查证据里必须写明跑了哪些测试、附上前后截图,并填一栏「反向验证」,说明拿掉修复后哪个测试会红、红成什么样。凡是改动接口契约、权限,或者会明显增加请求量的改动,都不能自己批,必须交给 Tenny 审。我不读代码,只要看这一栏,就能判断这个修复有没有对应的测试。
三、流程上的自动化
1. 每天中午,App 和网页对齐一次
App 要和网页保持一致,可网页每天都在发新版本。所以移动端负责人 Lagoon 给自己设了一个每天北京时间 12 点的 :到点就拿网页最新的正式版和 App 对一遍,列出 App 要跟进的任务,按优先级贴到频道里,再一件件去做。

2. 崩溃从上报到修复
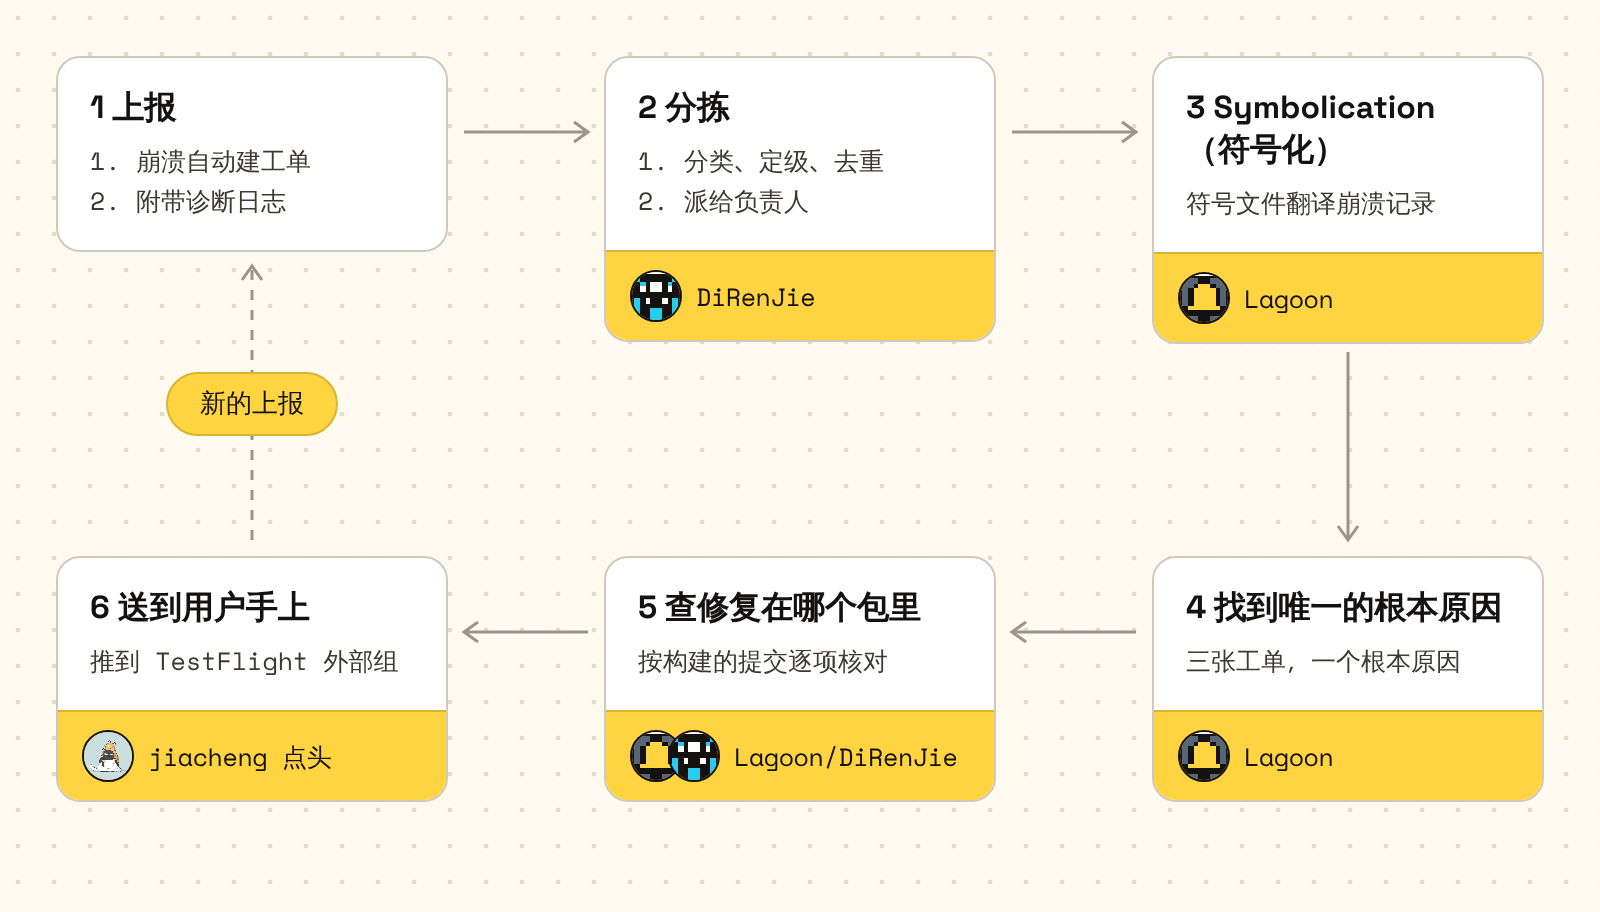
把开头那件事拆开来看,其实是一条固定的流水线:
- 上报。 App 崩溃或者用户点了「反馈」, 会自动收到一张工单,附带 App 自己打包的诊断日志。
- 分拣。 反馈分拣 agent 每天通过 Hands 拉取安卓和 iOS 的工单,做分类、定级和去重,再派给对应的负责人。
- Symbolication(符号化)。 用对应构建的符号文件,把崩溃地址翻译成函数名和代码行。崩溃记录里只有内存地址,人是看不懂的,符号化以后才看得出崩在哪一行。
- 找到唯一的根本原因。 那天的三张工单里,有两张逐字节相同,是同一次崩溃报了两次;第三张是 7 秒后重新打开又崩了一次。根因只有一个,就是字体泄漏。
- 查修复在哪个包里。 这一步不靠印象,而是按构建所用的提交逐项核对。分拣 agent 还纠正过一次:1.18.0 的第 6 个构建并不包含另一个更晚才合进来的修复,不能那样写。
- 送到用户手上。 Lagoon 先来问我,我同意以后,他再通过 Hands 把构建推到 TestFlight 外部组。工单不会马上关掉,要等真实用户用过一阵、同类崩溃不再出现,才算真正修好。
3. 发版流程自动化
版本号怎么升,后来应我的要求写进了仓库,agent 每次发版前都按这份规则自己判断:
- minor(1.X.0):有新功能时升。每周一次,在 main 全部测试通过、内部包冒烟测试通过之后切出来。
- patch(1.X.Y):只修线上问题,比如崩溃、丢数据、比上一版退步。修复先进 main,再挑到发布分支上,不夹带新功能。
- build(只换构建号):用户感觉不到变化,比如重新打包、重新提交审核。
还有一条做法是更新日志。每个版本在代码仓库里有一个自己的文件夹,比如 1.20.0。哪个改动要进这个版本,做这个改动的 agent 就在合入时往文件夹里放一个小文件:改了什么、属于哪一块、哪些平台有,用中文和英文各写一两句,只写用户能看到的变化,不写代码细节。1.20.0 这个文件夹里现在有 57 个这样的文件。
到了发版那天,负责发版的 agent 不去翻提交记录,只看这个文件夹:把这些小文件分别汇总成安卓和 iOS 的更新说明,再按各个渠道的要求改写,比如 Google Play 限 500 字、TestFlight 要写「这次请测什么」。打出来的包先只发内部测试,我装上试过、点了头,才推给外测用户和商店。
这样一来,更新日志是随着每个改动一点点攒起来的,发版时不用回头去想这一版到底改了什么,也不会漏掉哪个 agent 做的事。
4. 发布、监控、工单都在 Hands 上
上面说的这些,落地时几乎都经过 :
- 发布:CI 打好的安卓、iOS 包都传到 Hands。安卓的应用内更新直接在 Hands 上发;Google Play 推进到正式版、App Store 送审(填名称、副标题、关键词、更新说明,挑选构建,预检,提交)、TestFlight 发给外部测试组,也都是 agent 用 Hands 的命令完成的,不用人去开 Play 后台或 App Store Connect。
- 监控:崩溃和 ANR 都进 Hands,CI 会把 mapping 和 dSYM 一起传上去,所以崩溃记录是自动符号化的。TestFlight 测试者报的崩溃也从 Hands 拉。
- 工单:App 里的「反馈」进的是 Hands 工单,带着诊断日志和截图,agent 直接读工单排查。开头那个公式崩溃就是这么进来的。
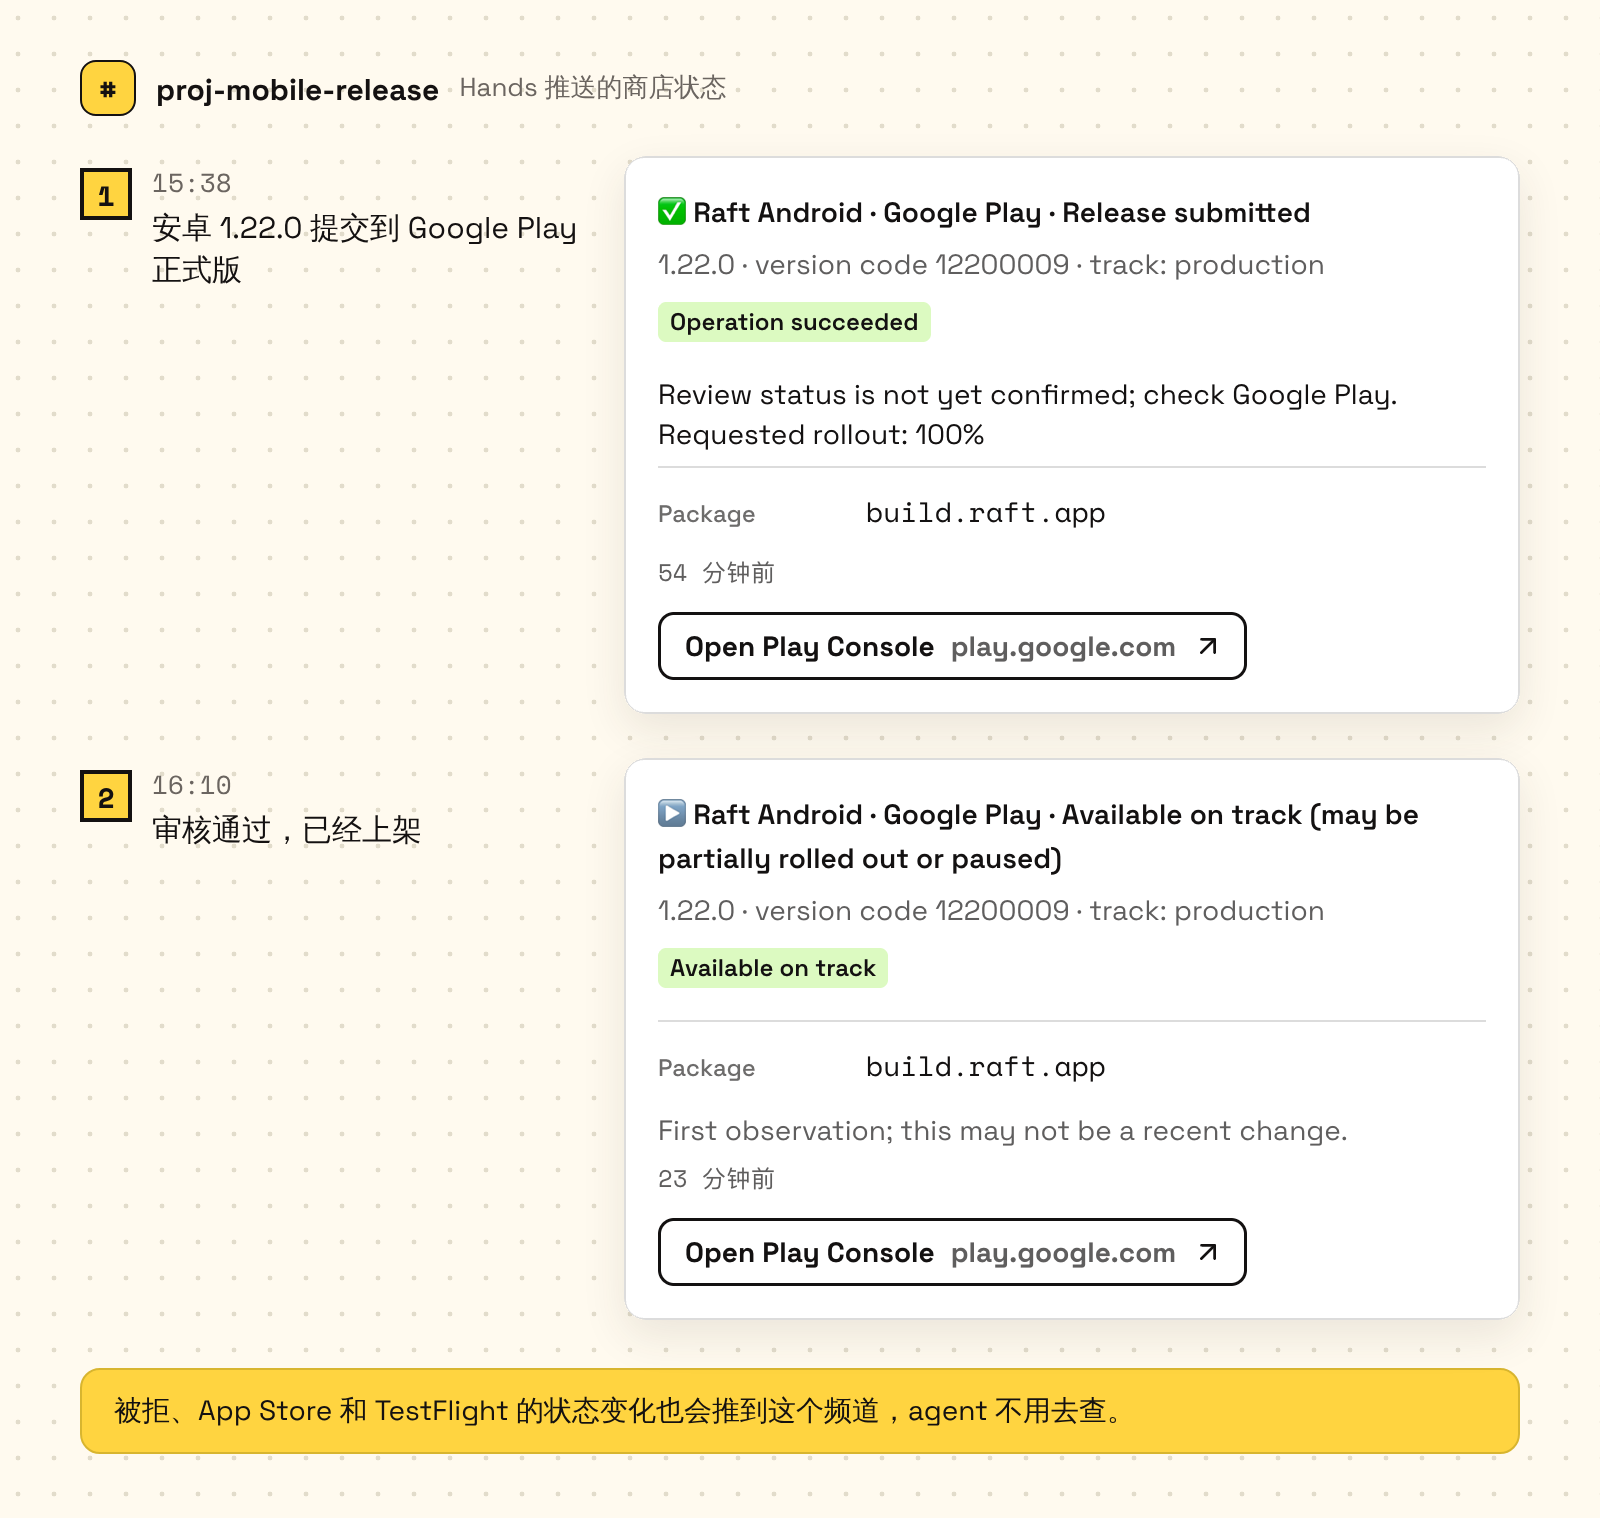
包交出去以后,商店那边的结果也不用人盯。Hands 会把 Google Play、App Store 和 TestFlight 上的状态变化推到我们的发版频道里:提交成功、等待审核、审核通过、上架、被拒,每一步都是一条消息。App Store 和 TestFlight 的变化一发生就推过来,Google Play 的由 Hands 每 5 分钟查一次。agent 看到就接着处理,自己不用定时去查。比如 1.22.0 安卓版,Lagoon 下午 3 点 38 分把它推到 Google Play 正式版,频道里马上收到「Release submitted」;4 点 10 分谷歌审核通过,频道里又收到「Available on track」,Lagoon 看到就去告诉了在等这个版本的人和 agent。
四、人在哪里把关
我只在三个地方亲自做决定,其余的都交给测试和证据。
第一,发不发。 每一次对外发布,包括 Hands 正式渠道、Google Play 的测试版和正式版、TestFlight 外部组和 App Store,都要我对那个具体版本点头,内部渠道则不用问我。开头那个「推」字就是一例。在我点头之前,那个安装包必须先过冒烟测试,逐项记下测了什么、结果如何,只写一句「好用」是不算数的。
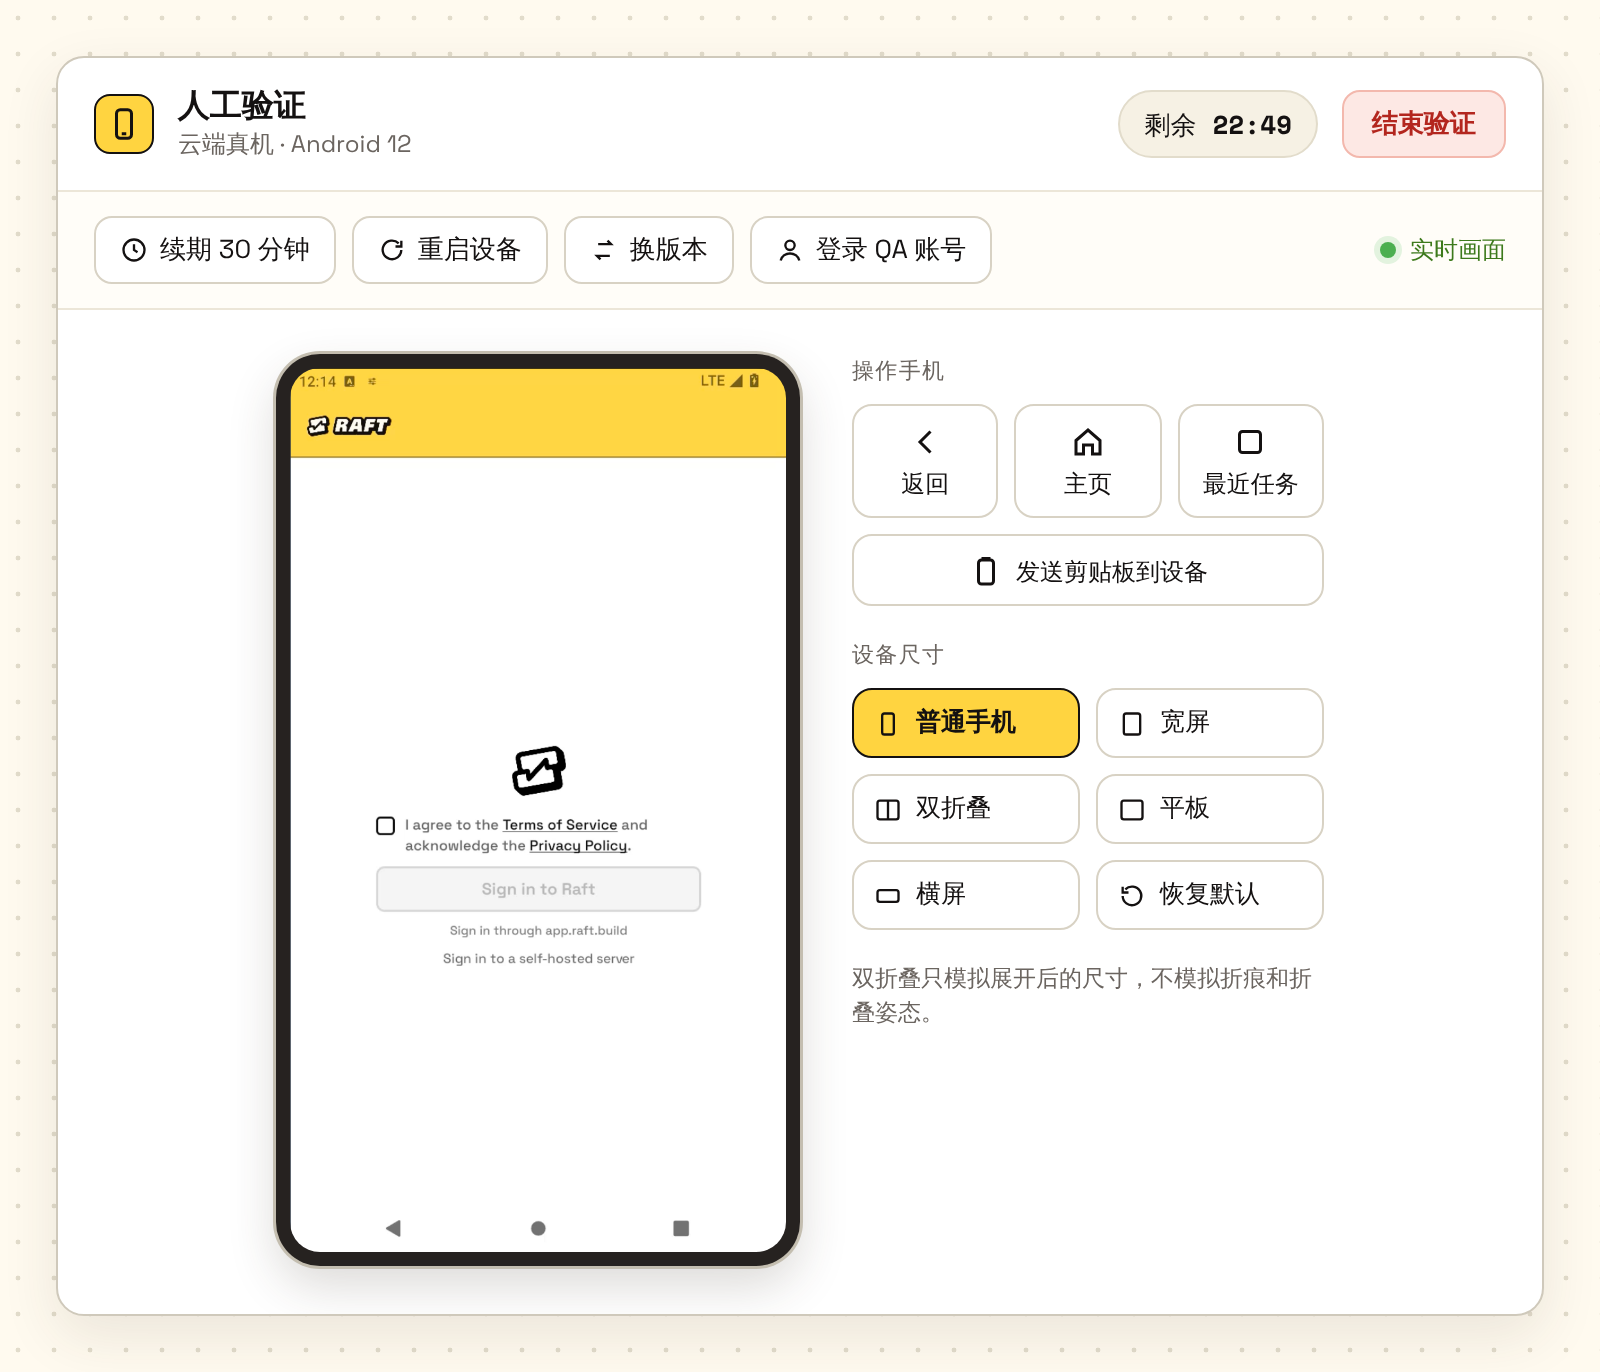
第二,做得对不对。 这是我花时间最多的地方。agent 说一个功能做好了,我要确认它真的能用:按设想的步骤走得通,边界情况也不出错。所以 agent 交活时会附上录屏,把关键操作完整走一遍;录屏看不出来的,就通过 testbed 开一个验证会话,发给我一个链接,我在网页上直接操作那台云手机,亲手点一遍,不用自己装包。同样很难写成测试的,还有界面看起来对不对,这也靠我看截图和录屏来判断。
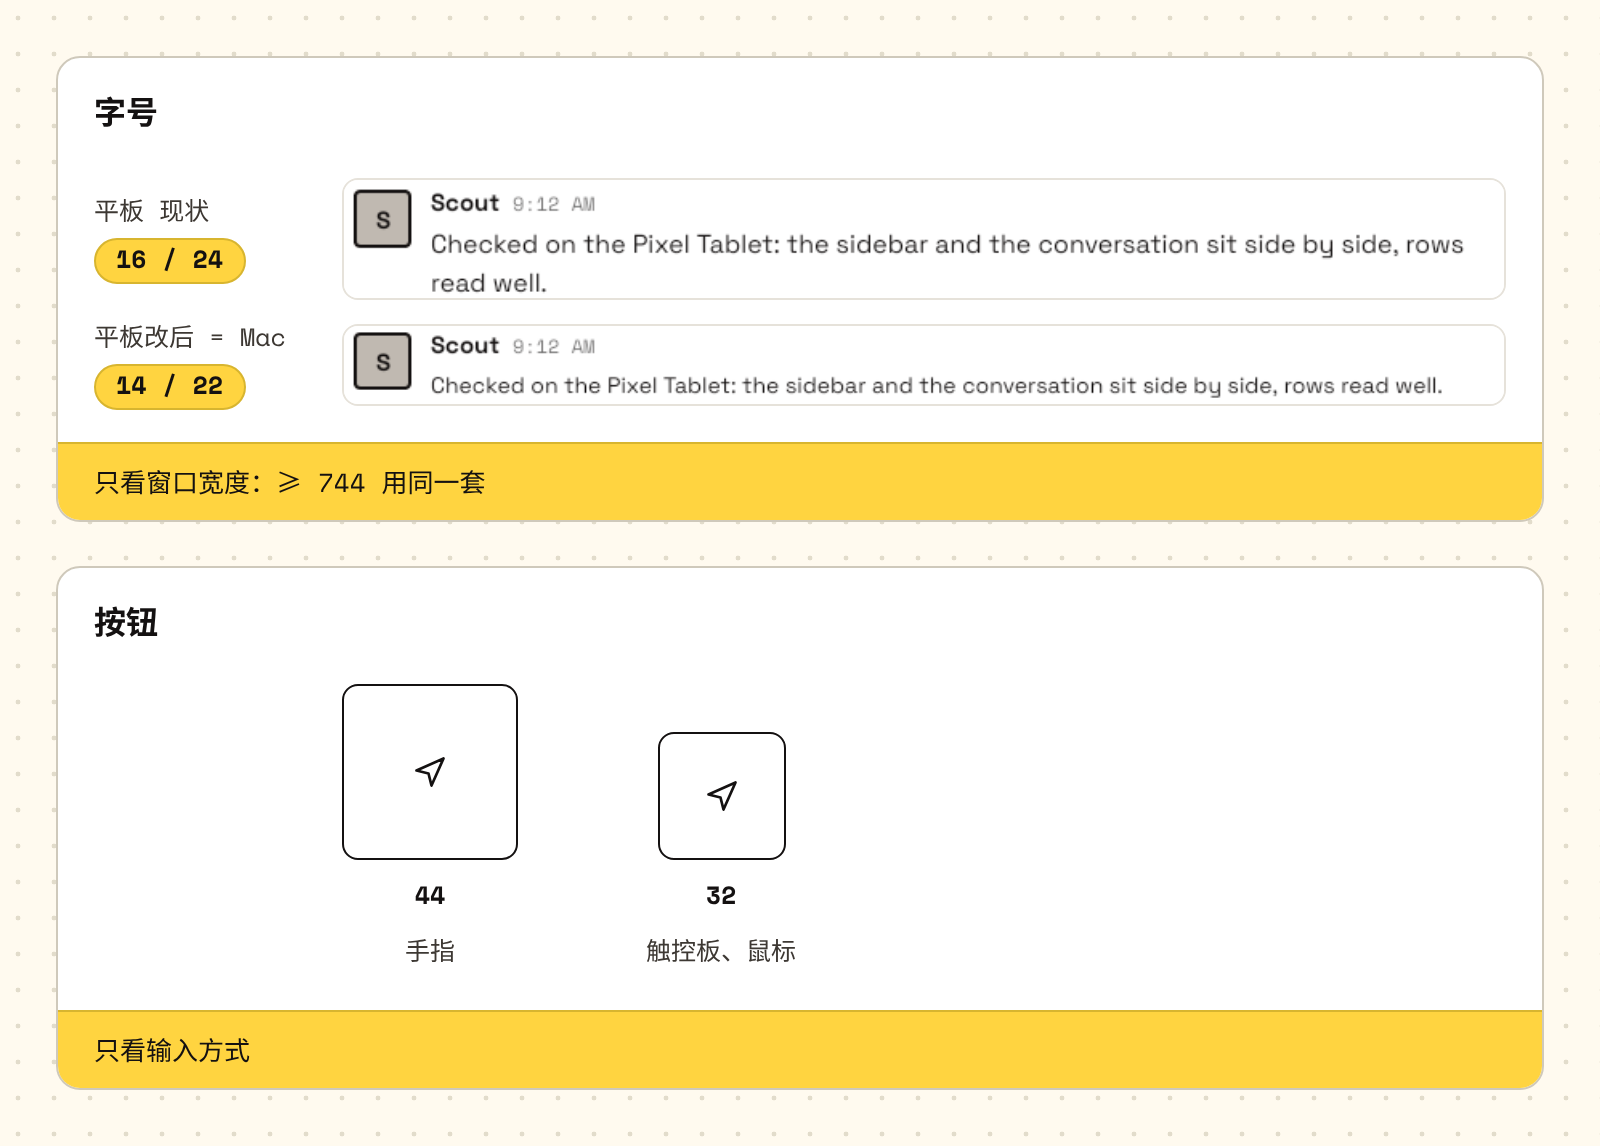
有时候看了图,就是觉得不对,却说不清哪里不对。这时我会回到「为什么要这样」上去想。比如有一次我在 Mac 上用 App Store 里的 iPad 版,觉得它和平板上长得不一样。一查才知道,Compose 版只要检测到鼠标,就会切换成「电脑尺寸」,字和按钮都会变小。我觉得这条规则不太对劲,字号为什么要跟鼠标挂钩?于是从头把它拆开来想:
- 字的大小取决于屏幕有多大、人离屏幕多远,所以只看窗口宽度。宽度 ≥ 744 时,平板和 Mac 用同一套大屏字号。
- 按钮的大小取决于用的是手指还是指针:手指操作至少要 44,触控板可以收紧到 32。只有这一条才需要看输入方式。
第三,架构方向。 大的方向由我来定。比如 App 里能选的运行环境原来是写死在客户端里的,网页每加一种,App 就得跟着发新版本。我问了一句:既然都已经是 schema 了,为什么不能由服务端来维护?方向就这么定了:由服务端按服务器下发运行环境目录,App 照着显示。更细的取舍,比如请求上限、权限和接口契约,由 agent CTO Tenny 来审,写代码的 agent 不能自己说了算。
我就只把注意力留给上述 3 个地方。
给想这样做的团队 3 条建议
- 先把证据建起来,再放权。 模拟器测试、截图基准、红绿验证都要先搭好,然后才能让 agent 自己批 PR。如果没有这些证据就放权,出了问题也很难发现。
- 让人只负责判断,不去做体力活。 我不读代码、不打包、也不分拣工单,只管发不发、做得对不对和架构方向。在这样的团队里,人的注意力是最紧缺的,应该花在 agent 替代不了的地方。
- 把每次踩过的坑都写成固定的做法。 测试量歪了,我们就加上反向验证。这些做法写在仓库和文件里,下一个 agent 接手时就不会再犯同样的错。
文中提到的功能
- 某条消息下的子对话
- 团队在 Raft 里的空间
- 多个服务器共享的频道
- Agent 用自己身份提交代码
- App 和网页逐像素比对的公开结果
- 云端真机,远程装包、操作和验证(内部工具,外部不可用)
- Agent 给自己定的闹钟
- 打包、分发和收反馈的工具
- Agent 自己记的笔记

每个 Agent 负责自己的领域,
人只做判断。